


Was Server-Side Tracking kann und darf
Server-Side Tracking erklärt: wie es funktioniert, ob es DSGVO-konform ist, wovon die Kosten abhängen und wann sich der Umstieg für deine Kampagnen lohnt.
Kurz gesagt: Server-Side Tracking verlagert die Datenerfassung vom Browser deines Nutzers auf einen eigenen Server, den du kontrollierst. Statt dass Skripte im Browser direkt mit Google, Meta und Co. sprechen, laufen die Daten erst über deinen Server und von dort weiter. Das macht die Messung robuster gegen iOS-Restriktionen und Ad-Blocker und gibt dir mehr Kontrolle für die DSGVO. Maze & Friends aus Wien richtet Server-Side-Tracking mit Consent-Management ein.
Wenn du Budget in Google Ads oder Meta steckst und am Monatsende nicht sicher sagen kannst, welche Kampagne Leads gebracht hat, optimierst du auf unvollständige Zahlen. Zwischen iOS-Tracking-Schutz, Ad-Blockern und den Anforderungen der DSGVO ist klassisches Tracking im Browser löchrig geworden. Server-Side Tracking ist die Antwort darauf, ein technischer Umbau deiner Messinfrastruktur. Hier erfährst du, was dahintersteckt, ob es datenschutzkonform ist, wovon die Kosten abhängen und wo die Grenzen liegen.
Was ist Server-Side Tracking?
Server-Side Tracking bedeutet, dass die Ereignisse auf deiner Website, etwa ein Seitenaufruf, ein Klick oder ein abgeschlossenes Kontaktformular, nicht mehr direkt aus dem Browser an Google, Meta oder andere Tools geschickt werden. Du schickst sie zuerst an einen Server, der dir gehört. Erst dieser Server leitet die Daten weiter.
Technisch klingt der Unterschied klein, in der Wirkung ist er groß. Beim klassischen Client-Side Tracking lädt der Browser deines Besuchers eine Reihe von Skripten von Drittanbietern, etwa das Google-Tag, das Meta-Pixel und vielleicht noch ein Analyse-Tool. Jedes dieser Skripte kommuniziert direkt mit dem jeweiligen Anbieter. Der Browser ist der Postbote, und jeder kann ihm über die Schulter schauen: Ad-Blocker, Browser-Schutzmechanismen, der Nutzer selbst.
Beim Server-Side Tracking sitzt zwischen deiner Website und den Tools eine Zwischenstation, meist umgesetzt über einen Server-Side Google Tag Manager (sGTM). Dein Browser spricht nur noch mit deinem eigenen Server, und der übernimmt die Weiterleitung. Das reduziert die Zahl der Skripte im Browser und macht deine Seite oft schneller. Vor allem aber entzieht es die Datenweitergabe der direkten Sichtbarkeit von Blockern. Google beschreibt in seiner Einführung in das serverseitige Tagging, dass nur du Zugriff auf die Daten im Server-Container hast, bis du sie weitergibst, und empfiehlt, den Server unter deiner eigenen Domain zu betreiben.
Willst du zuerst die Grundlagen sauber aufsetzen, lohnt sich ein Blick auf unseren Leitfaden zu GA4 richtig einrichten. Server-Side baut darauf auf und ersetzt es nicht.
Was ist der Unterschied zwischen client-side und server-side Tracking?
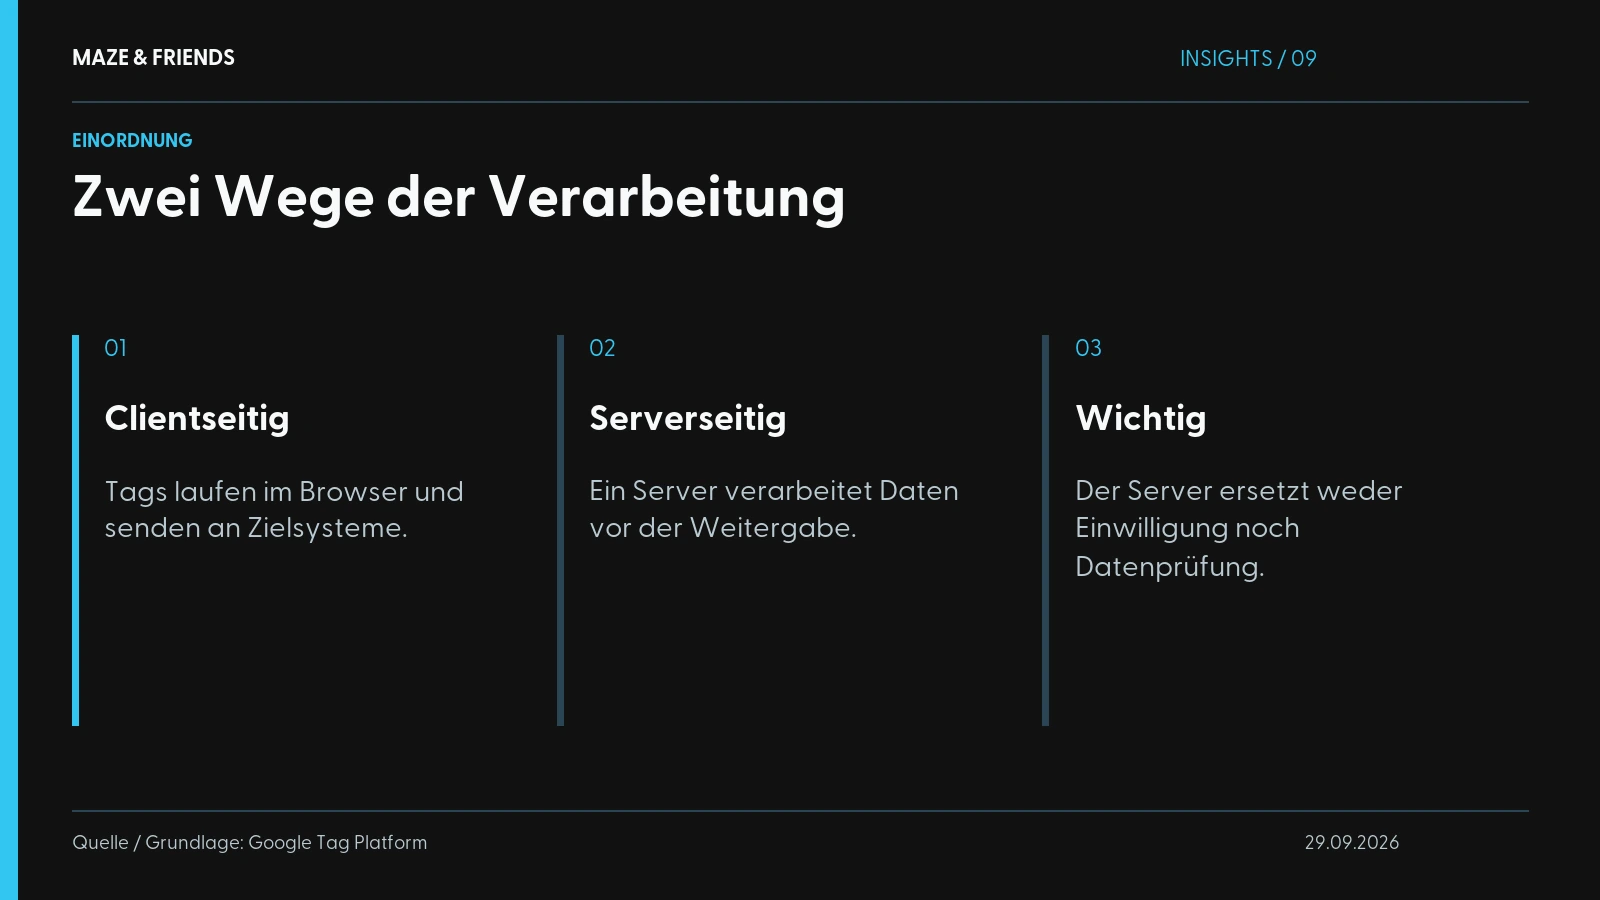
Der Unterschied liegt darin, wo die Daten gesammelt und verarbeitet werden: im Browser oder auf deinem Server.
Im direkten Vergleich:
| Aspekt | Client-Side Tracking | Server-Side Tracking |
|---|---|---|
| Wo laufen die Daten? | Direkt im Browser an Drittanbieter | Erst an deinen Server, dann weiter |
| Ad-Blocker | Blockieren Skripte oft komplett | Deutlich schwerer zu blockieren |
| iOS / Browser-Schutz | Kürzt Cookie-Lebensdauer, blockiert Tracker | Server kann Daten robuster verarbeiten |
| Ladezeit der Seite | Viele Drittanbieter-Skripte im Browser | Weniger Skripte, oft schnellere Seite |
| Kontrolle über Daten | Gering, alles fließt direkt ab | Hoch, du filterst, was rausgeht |
| DSGVO-Handhabung | Schwerer sauber umzusetzen | Mehr Kontrolle über Datenweitergabe |
| Aufwand & Kosten | Niedrig, Standard-Setup | Höher, Server + Einrichtung nötig |
Server-Side ersetzt Client-Side nicht komplett. In der Praxis läuft meist ein hybrides Setup: Bestimmte Signale brauchen weiterhin den Browser, andere gehen über den Server. Die Kunst liegt darin, beide sinnvoll zu kombinieren.
Gewonnen ist damit vor allem eines. Beim Client-Side Tracking bist du darauf angewiesen, dass der Browser mitspielt. Tut er das wegen iOS-Einstellungen, eines Ad-Blockers oder strenger Browser-Voreinstellungen nicht, verlierst du das Ereignis komplett. Über den Server hast du die Chance, dieses Signal trotzdem sauber zu verarbeiten und weiterzugeben, und genau das bringt dir das Setup in der Praxis.
Ist Server-Side Tracking DSGVO-konform?
Automatisch ist Server-Side Tracking nicht DSGVO-konform. Es gibt dir aber die Werkzeuge, um es konform zu machen.
Ein weit verbreitetes Missverständnis lautet: „Wenn die Daten über meinen eigenen Server laufen, ist alles automatisch datenschutzkonform.“ Das stimmt so nicht. Server-Side Tracking ist ein technisches Verfahren und kein Freifahrtschein. Ob dein Setup rechtssicher ist, hängt davon ab, wie du es einsetzt.
Beim Datenschutz zählt tatsächlich:
- Einwilligung bleibt Pflicht. Auch wenn Daten über deinen Server laufen, brauchst du weiterhin eine gültige Einwilligung deiner Nutzer, bevor du personenbezogene Daten verarbeitest oder weitergibst. Ohne Consent-Management geht es also nicht.
- Datenweitergabe an US-Anbieter bleibt heikel. Leitet dein Server Daten an Google oder Meta weiter, findet weiterhin eine Übermittlung statt. Empfänger und Rechtsgrundlage müssen auch mit Server-Side sauber dokumentiert sein.
- Der Vorteil: mehr Kontrolle. Hier liegt die echte Stärke. Weil die Daten erst über deinen Server laufen, kannst du sie filtern, bevor sie das Haus verlassen: IP-Adressen kürzen, sensible Parameter entfernen, nur einwilligungsbasierte Signale durchlassen. Diese Datenhoheit bekommst du beim reinen Client-Side Tracking so nicht.
Für den DACH-Markt ist das der springende Punkt. Datenschutz ist hier ein echter Einwand im Vertrieb, gerade im Industrie-Mittelstand mit langen Entscheidungsketten und aktiver Rechtsabteilung. Server-Side Tracking gibt dir die technische Grundlage, sauber zu arbeiten. Die rechtliche Bewertung deines konkreten Setups gehört aber in die Hände deines Datenschutzbeauftragten oder eines spezialisierten Anwalts. Das ersetzen wir dir nicht, und das sollte dir auch kein seriöser Dienstleister versprechen.
Wie hoch sind die Kosten für Server-Side Tracking?
Einen einheitlichen Preis gibt es nicht, weil sich die Kosten aus mehreren Bausteinen zusammensetzen. Bei Maze & Friends steht der Preis nach dem Erstgespräch als Fixangebot fest.
Typischerweise fallen diese Posten an:
| Kostenblock | Was dahintersteckt |
|---|---|
| Server-Hosting | Der Container für deinen sGTM läuft laufend, meist als monatliche Cloud-Gebühr, abhängig vom Traffic-Volumen |
| Einrichtung (einmalig) | Konzept, technische Umsetzung, Testing, Consent-Anbindung; der größte Einmalposten |
| Wartung & Anpassung | Tracking bleibt nie „fertig“: neue Kampagnen, Plattform-Updates, Fehlerbehebung |
| Consent-Management | Ein Tool für die Einwilligung, oft als eigenes Abo |
Als Faustregel gilt: Das Hosting selbst ist meist der kleinere Posten. Wert und Aufwand stecken in der sauberen Einrichtung. Ein schlecht konfiguriertes Server-Side-Setup misst genauso falsch wie ein löchriges Client-Side-Setup, nur teurer. Wer dir Server-Side Tracking als reines Hosting-Produkt verkauft, erzählt dir die halbe Wahrheit.
Und für wen lohnt sich der Aufwand? Je mehr Budget du in bezahlte Kanäle steckst, desto schneller zahlt sich die Investition aus. Bringen dich ungenaue Daten dazu, eine funktionierende Kampagne abzuschalten oder in die falsche zu investieren, kostet dich das mehr als das Setup. Bei kleinen Budgets ohne nennenswerten Paid-Anteil ist der Nutzen überschaubar. Dann setzt du besser zuerst dein Conversion-Tracking sauber auf und steigst erst später auf Server-Side um.
Wie setzt du Server-Side Tracking auf?
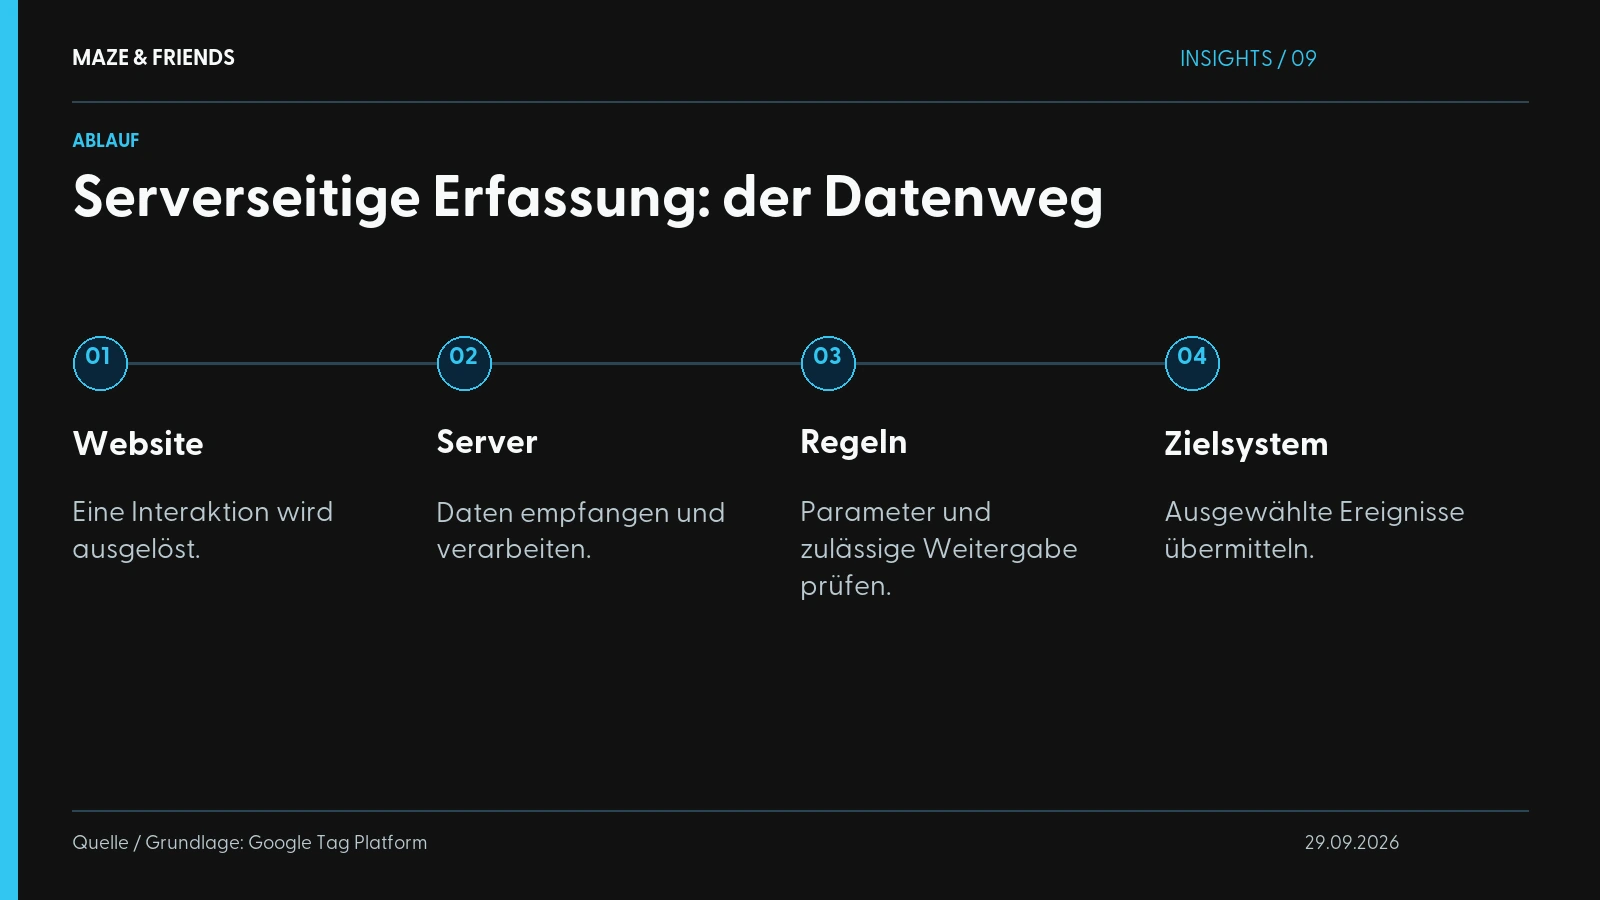
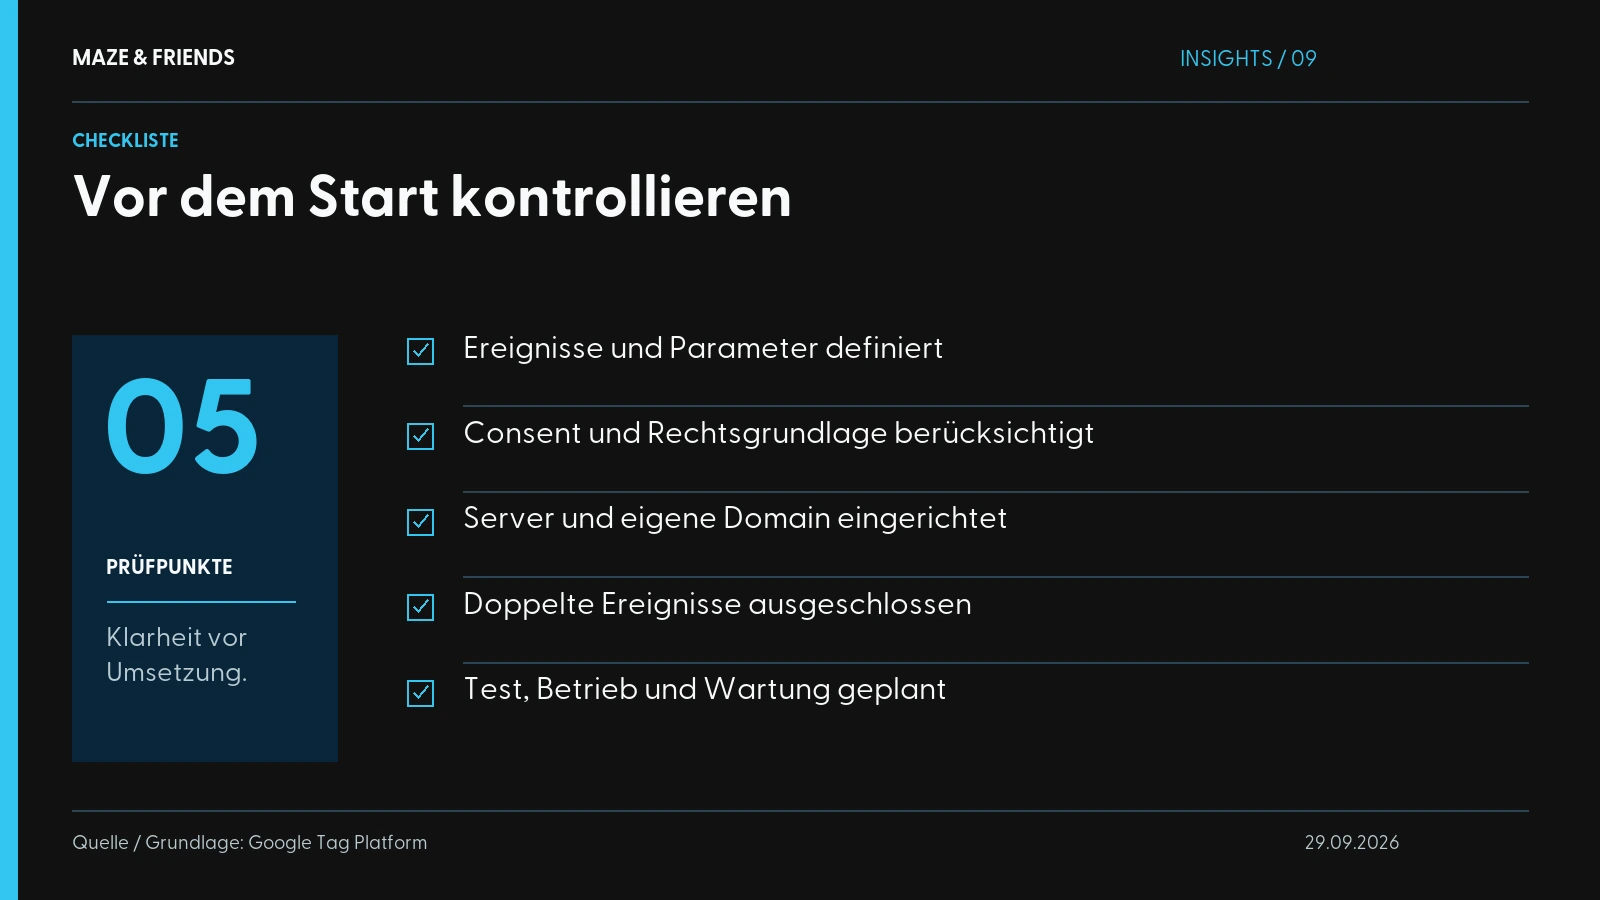
In der Praxis entsteht ein sauberes Setup in fünf Schritten. Ein Klick-Tutorial ist das bewusst nicht, weil jedes Setup individuell ist. Sieh es als Landkarte, damit du weißt, worauf du achten musst.
- Ist-Aufnahme. Was misst du aktuell, welche Ereignisse sind geschäftskritisch, welche Tools hängen dran? Ohne diesen Schritt baust du auf Sand.
- Server aufsetzen. Der Server-Side Google Tag Manager braucht eine eigene Umgebung, meist in einer Cloud, oft unter einer eigenen Subdomain deiner Website. Durch diese Subdomain gilt die Datenweitergabe technisch als „First-Party“ und funktioniert robuster.
- Consent zuerst. Die Einwilligung wird von Anfang an mitgedacht. Nachträglich draufschrauben funktioniert nicht. Nur was der Nutzer erlaubt, wird verarbeitet.
- Ereignisse anbinden. Deine wichtigen Signale wie Formular, Anfrage oder Download werden vom Browser an den Server und von dort an die Zieltools geschickt. Für Meta läuft das über die Conversions API (CAPI), für Google über die entsprechenden Schnittstellen. Läuft das Meta-Pixel parallel, braucht jedes Ereignis in beiden Wegen dieselbe Event-ID und denselben Namen, so steht es in Metas Anleitung zur Deduplizierung von Pixel- und Server-Events.
- Testen, testen, testen. Diesen Teil unterschätzen die meisten. Du prüfst für jedes Ereignis, ob es wirklich ankommt, nur einmal zählt und die Einwilligung respektiert. Erst wenn das steht, ist das Setup live-fähig.
An Schritt 5 scheitern Setups am häufigsten. Ein Server-Side-Aufbau, der nicht gründlich getestet wurde, gibt dir das trügerische Gefühl sauberer Daten und misst im Zweifel schlimmer als vorher. „Läuft“ heißt nicht „stimmt“.
Sauberes Tracking ist Handwerk
Investierst du ernsthaft in bezahlte Kanäle, gehört Server-Side Tracking heute dazu. Es ist die technische Antwort auf eine Realität, in der Browser, iOS und Datenschutz deine Messung im Browser Stück für Stück aushöhlen. Ein Zauberprodukt ist es trotzdem nicht. Weder macht es deine Daten automatisch DSGVO-konform, noch automatisch besser. Den Unterschied machen die saubere Einrichtung und das gründliche Testen, also Handwerk.
Maze & Friends richtet GA4, Server-Side-Tracking, die Conversions API und Consent-Management so ein, dass du deinen Zahlen wieder vertrauen kannst. Wenn du danach an der Umsetzung weiterarbeiten willst, lohnt sich ein Blick auf Conversion-Optimierung ohne Buzzwords, denn Messen ist nur der erste Schritt.
Du willst wissen, ob sich Server-Side Tracking für dein Setup rechnet und wo bei dir konkret Daten verloren gehen? Dann lass uns in einem unverbindlichen Erstgespräch draufschauen.
Aus der Werkstatt: Canal Toys: Shop, Ratgeber und Kampagnen · kiwiz: Content-Plan und Social Ads.
Häufige Fragen
Was bedeutet Server-Side Tracking einfach erklärt?
Server-Side Tracking bedeutet, dass Ereignisse deiner Website zuerst an einen eigenen Server gehen und erst von dort an Google, Meta und Co. weiterlaufen.
Beim klassischen Client-Side Tracking schickt der Browser deiner Besucher die Daten direkt an jeden Anbieter. Beim serverseitigen Weg spricht der Browser nur noch mit deinem Server, meist einem Server-Side Google Tag Manager unter einer Subdomain deiner Website. Du entscheidest, welche Daten in welcher Form weitergehen. Und die Messung wird robuster gegen Ad-Blocker und Browser-Schutz.
Client-Side oder Server-Side Tracking: Was ist besser?
Server-Side Tracking ist robuster und gibt dir mehr Kontrolle. Das Tracking im Browser ersetzt es aber nicht vollständig, in der Praxis läuft meist ein hybrides Setup.
Client-Side Tracking ist günstig und schnell eingerichtet, verliert aber Signale an Ad-Blocker, iOS und strenge Browser-Einstellungen. Server-Side kostet Hosting und Einrichtung, verarbeitet Ereignisse dafür robuster und filtert Daten, bevor sie weitergehen. Viele Signale entstehen weiterhin im Browser und werden nur über den Server weitergeleitet. Je mehr Budget du in bezahlte Kanäle steckst, desto eher lohnt sich der serverseitige Teil.
Was bedeutet Tracking und welche Arten gibt es?
Tracking heißt auf Deutsch Nachverfolgung. Im Online-Marketing bedeutet es, Aktionen von Website-Besuchern wie Seitenaufrufe, Klicks oder Anfragen zu erfassen und auszuwerten.
- Client-Side: Skripte und Pixel im Browser senden direkt an die Anbieter
- Server-Side: Daten laufen zuerst über deinen eigenen Server
- Hybrid: die Kombination beider Wege, in der Praxis der Standard
- Server-zu-Server: Schnittstellen wie die Conversions API von Meta melden Ereignisse direkt aus deinem System
Nach dem Zweck trennst du Web-Analyse, etwa mit GA4 oder Matomo, und Conversion-Tracking für Werbeplattformen.
Macht Server-Side Tracking mein Tracking automatisch DSGVO-konform?
Nein. Es gibt dir aber die technischen Werkzeuge, um Datenschutz sauber umzusetzen.
Der Vorteil ist Kontrolle. Weil alle Daten zuerst über deinen Server laufen, kannst du IP-Adressen kürzen, sensible Parameter entfernen und nur einwilligungsbasierte Signale weitergeben. Leitet dein Server Daten an Google oder Meta weiter, findet trotzdem eine Übermittlung statt. Bei US-Anbietern bleibt das heikel, Empfänger samt Rechtsgrundlage müssen dokumentiert sein. Die rechtliche Bewertung deines Setups gehört zu deinem Datenschutzbeauftragten oder einer spezialisierten Kanzlei.
Kann ich mit Server-Side Tracking auf den Cookie-Banner verzichten?
Nein, in der Regel brauchst du weiterhin ein Consent-Management. Ob Daten über den Browser oder deinen Server laufen, ändert an der Einwilligungspflicht nichts.
Der Server muss den Einwilligungsstatus aus dem Banner mitbekommen und nur Ereignisse weiterleiten, die erlaubt sind. Bei Google-Tags reicht der Consent Mode die Signale bis in den Server-Container durch, bei anderen Zielen wie Meta richtest du die Prüfung meist selbst ein. Teste gezielt, dass bei einer Ablehnung keine Daten an Werbeplattformen gehen. Am Banner vorbei führt auch der Server nicht.
Welche Anbieter für Server-Side Tracking gibt es?
Es gibt den selbst betriebenen Server-Side Google Tag Manager in der Google Cloud, Hoster wie Stape oder TAGGRS und Plattformen wie JENTIS.
Für Web-Analyse ohne Google lässt sich auch Matomo auf eigenen Servern betreiben und serverseitig mit Daten versorgen. Wichtiger als der Name sind drei Fragen: Wo stehen die Server, wer hat Zugriff auf die Daten, und wie gut lässt sich das Setup mit deinem Consent-Management verbinden? Lass dir vor der Entscheidung Serverstandort und Auftragsverarbeitungsvertrag zeigen.
Womit muss ich bei Server-Side Tracking an Kosten rechnen?
Mit laufendem Server-Hosting, einer einmaligen Einrichtung, laufender Wartung und meist einem Consent-Tool. Einen Einheitspreis gibt es nicht.
Das Hosting hängt vom Traffic-Volumen ab und ist meist der kleinere Posten. Der größte Einmalposten ist die Einrichtung mit Konzept, technischer Umsetzung, Consent-Anbindung und Tests. Wer das Know-how für Tag Manager und Cloud im Haus hat, spart bei der Umsetzung. Beim Testaufwand spart er nichts. Ein schlecht konfiguriertes Setup misst genauso falsch wie vorher, nur teurer.
Für wen lohnt sich Server-Side Tracking?
Vor allem, wenn du nennenswert Budget in Google Ads oder Meta investierst und deine Messung spürbar lückenhaft ist.
Lücken entstehen durch iOS, Ad-Blocker oder abgelehnte Einwilligungen. Je mehr Werbebudget, desto schneller rechnet sich der Umbau, weil unvollständige Daten zu falschen Budgetentscheidungen führen, etwa zum Abschalten einer Kampagne, die eigentlich funktioniert. Bei kleinen Budgets ohne nennenswerten Paid-Anteil ist der Nutzen überschaubar. Dann setzt du besser zuerst dein Conversion-Tracking im Browser sauber auf und ergänzt die serverseitige Ebene später.
Ist Server-Side Tracking dasselbe wie die Conversions API von Meta?
Nein. Die Conversions API (CAPI) ist Metas Schnittstelle für serverseitige Ereignisse, Server-Side Tracking der übergeordnete Ansatz, der solche Schnittstellen bedient.
Ein Server-Side-Setup schickt dieselben Ereignisse an mehrere Ziele, etwa per CAPI an Meta und über die Schnittstellen von Google an GA4 und Google Ads. Die CAPI ist also ein Baustein. Läuft parallel das Meta-Pixel im Browser, brauchen beide Wege eine gemeinsame Event-ID, damit Meta Käufe und Leads nicht doppelt zählt.
Wie funktioniert Server-Side Tracking mit dem Google Tag Manager?
Mit zwei Containern: Der Web-Container im Browser erfasst Ereignisse, der Server-Container empfängt und verteilt sie.
Im Server-Container nehmen sogenannte Clients die eingehenden Anfragen entgegen, etwa im GA4-Format, und Tags leiten die Daten an Ziele wie GA4, Google Ads oder die Conversions API von Meta weiter. Dazwischen kannst du Daten prüfen, kürzen oder ergänzen. Betrieben wird der Server-Container in einer Cloud oder bei einem Hoster, erreichbar unter einer Subdomain deiner Website, damit die Kommunikation im Namen deiner eigenen Domain läuft (First-Party).
Umgeht Server-Side Tracking Ad-Blocker und den Tracking-Schutz von Safari?
Es macht deine Messung deutlich robuster gegen Ad-Blocker und Browser-Schutz wie die Intelligent Tracking Prevention (ITP) von Safari. Vollständig umgehen kann es sie nicht.
Weil der Browser mit einer Subdomain deiner Website spricht, werden weniger Anfragen blockiert, und Cookies aus dem First-Party-Kontext halten oft länger. Der Web-Container läuft aber weiterhin im Browser und kann genauso blockiert werden. Robuster messen heißt auch nie, Ablehnungen im Cookie-Banner zu übergehen. Verlorene Signale holt Server-Side nur dort zurück, wo eine Einwilligung vorliegt.
Wird meine Website durch Server-Side Tracking schneller?
Oft ja, weil weniger Drittanbieter-Skripte im Browser deiner Besucher laden müssen.
Wie groß der Effekt ist, hängt davon ab, wie viele Tools du auf den Server verlagerst und wie schlank dein bisheriges Setup war. Ein Web-Container für die Erfassung bleibt in der Regel bestehen, ganz ohne Skript im Browser geht es also nicht. Als alleiniger Grund für den Umbau taugt die Ladezeit deshalb wenig, als Nebeneffekt ist sie willkommen. Miss die Ladezeiten vor und nach der Umstellung, statt dich auf Versprechen zu verlassen.
Wie lange dauert die Einrichtung von Server-Side Tracking?
Das hängt von der Zahl der Ereignisse, der angebundenen Tools und deinem Consent-Setup ab. Eine seriöse Pauschalzahl gibt es nicht.
Ein überschaubares Setup mit wenigen Ereignissen und einem Werbekanal ist schneller live als ein über Jahre gewachsener Bestand mit vielen Tools und Sonderfällen. Den Zeitplan bestimmt am Ende die Testphase. Fertig ist das Setup erst, wenn jedes Ereignis ankommt, nur einmal zählt und die Einwilligung respektiert. Plane auch nach dem Livegang Zeit für Kontrollen ein, weil neue Kampagnen und Plattform-Updates laufend Anpassungen bringen.
Woran erkenne ich, dass mein Server-Side Tracking sauber funktioniert?
Daran, dass jedes geschäftskritische Ereignis genau einmal in jedem Zielsystem ankommt und bei abgelehnter Einwilligung nichts weitergeleitet wird.
- Vorschaumodus des Server-Containers im Tag Manager
- DebugView in GA4
- Test-Tool im Meta Events Manager
- Abgleich mit Anfragen oder Käufen in CRM oder Shop
Verschieben sich deine Zahlen nach der Umstellung, ist das normal, weil du jetzt genauer misst. Unerklärliche Sprünge deuten dagegen auf doppelte Zählung oder fehlende Deduplizierung hin.
Wie kann ich Website-Besucher tracken?
Mit einem Analyse-Tool wie GA4 oder Matomo, eingebunden über einen Tag Manager und aktiv erst nach Zustimmung im Cookie-Banner.
Leg zuerst fest, welche Aktionen zählen, etwa Anfrage, Download oder Kauf, und miss sie als eigene Ereignisse. Für Werbekanäle kommen die Tags von Google Ads und das Meta-Pixel dazu. Gehen dir durch Blocker und Browser-Schutz spürbar Signale verloren und steckt viel Budget in Anzeigen, ergänzt du eine serverseitige Ebene. Die Reihenfolge zählt: Einwilligung und Ziele zuerst, Tools danach.
Nächster Schritt
Du willst wissen, was davon für dein Unternehmen passt? In 30 Minuten klären wir das gemeinsam. Kostenlos und unverbindlich.
Termin auswählen
Manuel Zellnig baut seit 2018 Sichtbarkeit für Unternehmen: Imagefilm, Personal Branding, Performance Marketing und KI-Sichtbarkeit. Diplomierter Werbefachmann der Werbeakademie Wien, Bachelor Business Management der FH Kärnten, Autor des Fachbuchs „Mobile Apps zur Messung der Kundenzufriedenheit“ (2017) und Kreativexperte der Wirtschaftskammer Österreich in zwei Transformationsleitfäden. Er misst, bevor er empfiehlt, und schreibt hier über das, was in Projekten tatsächlich funktioniert.
Veröffentlichungen und Interviews: WKO-Transformationsleitfaden Druckereien · WKO-Transformationsleitfaden Floristik · Interview bei Ghezzo · „Heute“ über Wiener Start-ups